AI 把全世界的细胞塞进了同一张地图:从酵母到人类,15 亿年的生命语法第一次被机器读通
第 一 节一句话说清:给全世界每一个细胞,发一张通用坐标卡
2026 年 9 月 14 日,斯坦福医学院对外公布了一项工作进行总结:他们做出了两个"细胞的通用大模型"——UCE(Universal Cell Embedding,通用细胞嵌入)与它的第二代TranscriptFormer。前者的论文 2026 年 7 月 8 日发表在《自然》(Nature 第 656 卷,183–191 页),后者 5 月 7 日发表在《科学》(Science 第 393 卷,第 6806 期)。牵头人是斯坦福生物工程教授 Stephen Quake、计算机科学教授 Jure Leskovec,以及陈·扎克伯格基金会(CZI)的 Theofanis Karaletsos。
一句话版本是这样的:过去,科学家要比较两个物种的细胞,得像对暗号一样,先费力找出两边"长得一样"的对应基因;现在,他们可以直接把细胞丢进同一个数学空间,谁像谁、谁可能是从谁那儿演化来的,一目击穿。
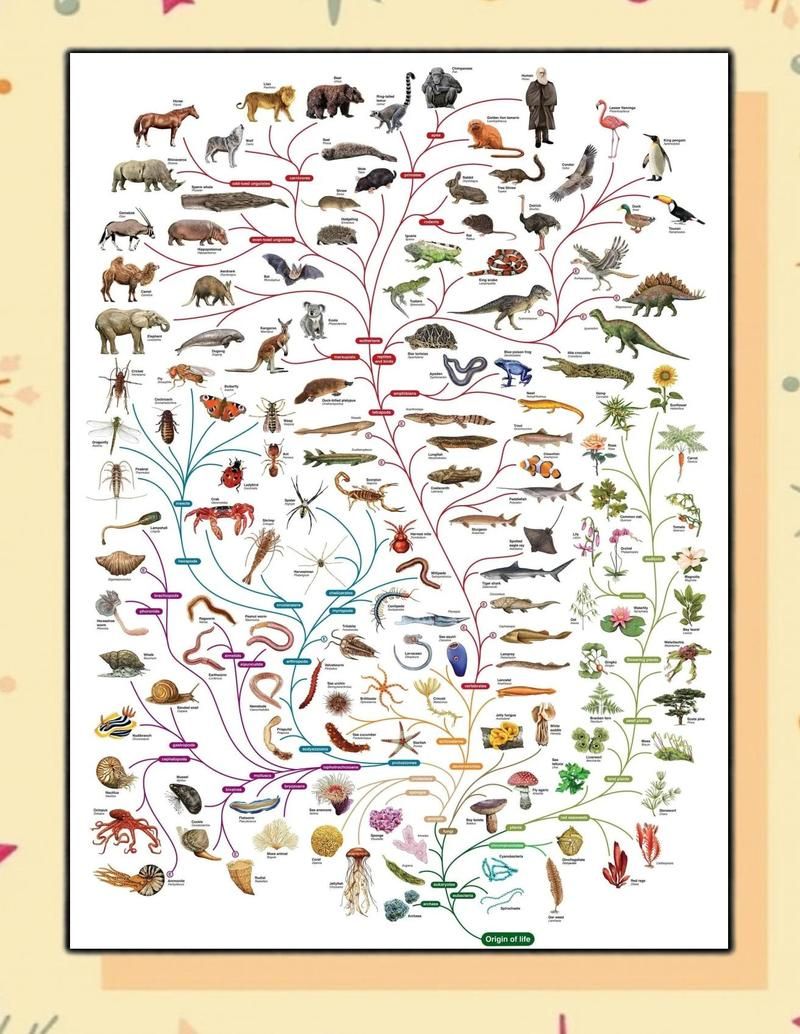
这个空间里现在装着什么?UCE 装进去了 3600 万个细胞、8 个物种、1000 多种有正式命名的细胞类型;TranscriptFormer 更狠,12 个物种、最多 1.12 亿个细胞,从人、小鼠、兔子、鸡、非洲爪蟾、斑马鱼,一路铺到海胆、线虫、果蝇、淡水海绵、酵母,最后到引起疟疾的疟原虫——这些生命形态之间的分歧,横跨大约 15.3 亿年的进化史。
Quake 自己的一句话是这么说的:"我们想打开一种全新的思考细胞生物学的方式。"他的同事、共同通讯作者之一 Leskovec 更直白:这些论文"是一个新领域的开端,我们预计要在上面干十年"。
第 二 节怎么做到的:把一整个细胞,当成一句话来读
要理解这件事有多难,得先说清楚今天的生物学家在忙什么。
人体大约有 37 万亿个细胞,它们基因几乎完全一样,但肝细胞和神经细胞干的事天差地别。区别不在"有没有某个基因",而在"这个基因此刻开不开、开多大"。一个细胞里两万个蛋白编码基因,通常只有一两千个在活跃地干活。而检测这件事的技术——单细胞 RNA 测序(scRNA-seq)——原理并不玄:把组织打散成单个细胞的悬浮液,用带条形码的液滴把小细胞一个个包起来,再把每个细胞里的 RNA 反转录、测序、计数。于是每个细胞就变成了一份长长的清单:哪些基因在开,各开了多少。
十年来这样测出来的数据,堆成了"细胞图谱"——人类细胞图谱(Human Cell Atlas)、Tabula Sapiens、CZ CELLxGENE 数据库。Quake 形容这种数据量时的原话很朴素:"我们怎么同时思考这么多基因?人脑做不到。"
UCE 的解法,分三步,每一步都值得细看。
第一步,把细胞变成一个"RNA 袋"。这是物理学家 Sydney Brenner 早年的一个比喻,被这群斯坦福人做成了工程。对一个细胞,UCE 先只看表达量不为零的基因,然后有放回地随机抽 1024 个——表达越高的基因,越容易被重复抽到。这样,一张稀疏、长度不一的表达矩阵,就变成了固定长度的"基因多集合"。
第二步,也是最关键的一步:不给基因用名字,而是用它的蛋白质"长相"当词向量。每个抽到的基因,先翻译成它编码的蛋白质,再用 ESM-2(Evolutionary Scale Model 2,一个 150 亿参数的蛋白质语言模型)得到 5120 维的嵌入向量。基因不再是"人类基因名叫 TP53"这种东西,而是一串氨基酸序列的语义表示。
第三步,把这些向量按染色体分组、组内按基因组位置排好序,染色体之间插特殊分隔符,最前面加一个代表整个细胞的 CLS token,然后送进一个 33 层、6.5 亿参数的 Transformer。训练目标朴素得惊人:随机遮住大约 20% 已表达的基因,让模型猜某个基因在不在。全程不用一个细胞类型标签。硬件账也很实在——24 块 A100 80GB,跑了 40 天。最后每个细胞得到一个 1280 维的坐标。
TranscriptFormer 往前走了一大步。它不再满足于"抽一袋基因",而是把整个转录组当作一个句子,自回归地按顺序预测下一个基因是谁、表达多少。它用了"表达感知多头注意力"(表达量高的基因在注意力里权重更大)、因果遮罩,以及一个对转录本计数的概率分布建模(count likelihood),来对付测序数据的噪声。为比较训练数据的广度到底有多重要,团队训了三个版本:TF-Metazoa(12 物种、1.12 亿细胞、4.44 亿可训练参数、词表 24.7 万)、TF-Exemplar(人 + 小鼠、斑马鱼、果蝇、线虫 5 个物种、1.1 亿细胞)、TF-Sapiens(纯人类、5700 万细胞)。三者架构一样,差别只在"喂什么长大的"。
两套模型的代码和权重都没藏着。UCE 在斯坦福 SNAP 组的 GitHub 上,TranscriptFormer 直接开源在 czi-ai/transcriptformer,pip install transcriptformer 就能装,A100 40GB 可推理,显存小一点也能把批大小降到 1 跑。
第 三 节为什么重要:它一口气拆掉了三堵墙
第一堵墙,叫"直系同源基因"。传统跨物种比较有个硬前提:你得先找到两个物种里"同一个基因"。人类和小鼠还好说,人跟海绵、跟酵母之间,共享的同源基因少得可怜,比较范围越拉越窄。而 TranscriptFormer 用蛋白嵌入替代基因名,只要你知道一个基因编码的氨基酸序列,模型就能"读"它——不需要预先算好同源对照表。效果如何?在六个脊椎动物的精子发生数据集上做跨物种细胞类型迁移,它明显好于同源映射的基线;对与人类分化已超过 6.85 亿年的物种(比如石珊瑚),细胞类型分类的宏平均 F1 仍能维持在 0.65 到 0.91 之间,而 UCE 在远缘物种上就掉下来了。
第二堵墙,叫"人类中心主义"。这几年单细胞领域几乎所有基础模型(scGPT、Geneformer、scFoundation)都以人类数据为主,逻辑是"数据越纯越好"。TranscriptFormer 的三个版本恰好做了一次对照实验:在多物种数据上长大的 TF-Metazoa,在人类新数据集(Tabula Sapiens 2.0,58 万细胞、27 种组织、167 个批次,训练时还没发表)上的细胞分类表现,并没有输给纯人类模型,甚至略优;只有在新冠感染、胶质母细胞瘤这类"必须靠人类疾病细节"的任务上,纯人类版 TF-Sapiens 才拿第一。进化广度不但没拖后腿,反而给了模型一种更通用的"生物直觉"。
第三堵墙,叫"人工标签"。这是最让行家兴奋的一点:模型从没被喂过细胞类型标签、发育阶段标签、系统发育注释,可是这些结构自己从坐标里"长"了出来。精子发生的各个阶段,在嵌入空间里按教科书顺序自然排开;一个物种的细胞嵌入与另一个物种的余弦相似度,会随进化距离增大而下降,统计上显著(Spearman R = −0.705);而只把蛋白质序列简单平均、不学转录组的那个对照组(ESM2-CE),这个相关性几乎没有(R = −0.06)。换句话说,"物种之间的远近"这件事,不是蛋白质序列自带的,是大规模转录组数据训练出来的。
还有一个变化值得单独说:细胞图谱从"查询表"变成了"虚拟仪器"。 TranscriptFormer 的生成式接口允许你"提问"——例如用点式条件互信息(PMI)计算转录因子与其他蛋白编码基因的关联,找出高置信度配对,再拿 STRING 数据库交叉验证。模型把 E2F8、FOXM1、MYBL2 连到复制与纺锤体调控基因上,把 SPIB 连到 B 细胞标志物上——这些关系它没被教过,是自己从表达分布里推出来的。
第 四 节它对普通人的生活意味着什么
先说近的,未来三五年内就可能落到你身边的两件事。
一是诊断试剂的"隐性漏洞"。今天大量的检测——包括很多抗体试剂盒、免疫组化、快速检测——是针对某个"标准"蛋白序列设计的。如果同一个基因在真实细胞里还会产生其他形式的蛋白变体,那么针对标准序列设计的试剂,敏感度和特异度都可能悄悄打折。同一批论文里有一条很说明问题的旁证:绿猴淋巴结数据中原本被标注为 B 细胞的一群细胞,在 UCE 的共享空间里自成一簇,差异表达分析显示它们高表达 Cd3d、Fyb1、Il7r、Hcst、Gzmk——这些是 T 细胞的经典标志物。一个跨物种坐标系,顺手指出了别人原始注释里的错。
二是药物研发的"预筛选"环节。TranscriptFormer 在沙利度胺同类的 Tahoe-100M 药物扰动数据上做了测试:在 95 种化合物的处理 vs 对照二分类里,纯人类版 TF-Sapiens 拿到最高的平均 AUC,其中 TAK-901、Bortezomib、PH-797804 几种几乎可以完美区分。更引人注意的是"零样本"能力——模型没见过新冠感染的专门训练数据,仍能跨供体地把感染与未感染的细胞分开。这意味着大量湿实验可以少做几轮:先在模型里筛,再把预算留给最有希望的组合。
再往远了看,是学术界念叨了快二十年的那个词——"虚拟细胞"(virtual cell)。Quake 在接受采访时说了一句很有分量的话:这类模型"可以想象出今天还不存在的功能细胞",从而指导细胞疗法的设计。也就是说,未来的再生医学流程可能不再是从几百个候选方案里一个个试,而是先在坐标空间里"生成"一个符合要求的细胞状态,再回到实验台上把它造出来。当然,这一天还很远,但它第一次有了可操作的入口。
还有一类容易被忽略的受益者:非模式物种。没有完善基因注释的蛙、鱼、昆虫、珊瑚,过去在分子层面几乎无法被定量解读;现在只要测出表达谱,就能被投进同一个坐标系里做对照。这对生物多样性研究、农业育种、生态监测的意义,可能比医学来得更早。
第 五 节争议与未解之处:哪些话现在还说不实
第一,模型是黑箱。UCE 论文的讨论部分自己就承认了这一点:很难解释为什么某些嵌入会呈现成那样,可解释性工具亟需开发。一个连作者都说不清"它为什么这么判断"的模型,放进临床或监管流程还早得很。
第二,训练数据有明显的偏见。3600 万细胞绝大多数来自哺乳动物,人类和小鼠占了大头,脑组织样本占比偏高。对训练不足的类群和语境——比如无脊椎动物、非模式生物、罕见组织——它的泛化能力是有问号的。
第三,一条更尖锐的反驳:"数据越多不一定越好"。2026 年,DenAdel 等人在《自然·方法》上训练了 400 个模型,在最多 2220 万细胞的语料上评测了 6400 个"模型—任务"组合,结论是:性能常常在最大语料之前就饱和了,找不到清晰的数据缩放律。这一结果直接否掉了"细胞越多,下游生物学表现越好"的自动推论。它并不证明加数据没用,但它证明"堆数据"不是一条自动生效的捷径。
第四,独立验证不足。必须如实说:Phys.org 在报道这项工作时明确划出了一条证据边界——除论文自己给出的几个案例研究之外,目前没有独立的基准测试或外部验证。F1 分数很好看,但任务、数据集、评测口径都是论文团队自己挑的。
第五,跨物种的生物学解释必须踩刹车。论文里最抓眼球的那段——把淡水海绵的领细胞(choanocyte)映射到线虫和爪蟾的初级感觉神经元、把海绵的"神经样细胞"映射到蛙的腺细胞——作者自己明确强调,这种跨越 6 亿年以上的细胞类比需要谨慎。坐标上的相似是统计相关性,不是同源性的证明。正如论文摘要里那句克制的补充:生物学的解释需要"领域知识把关"。
第六,结构性局限还在。批次效应处理尚未统一;物种覆盖不均;目前主要靠转录组一种模态,缺蛋白质组、代谢组和空间信息;"同一细胞类型在不同组织里的细微差别"能不能稳定捕捉,也仍属开放问题。更根本的一个隐忧是:如果训练语料以人类疾病样本为主,模型学到的"正常"可能本身就是被人类样本定义的——那它判断"异常"时,未必是在判断生物学,可能只是在判断"不像人类的平均"。
第 六 节一个值得玩味的细节
海绵身上有一种细胞,一百多年来被叫作 neuroid cell,"神经样细胞",因为它长着一点像神经元的形状,学界的默认理解是它参与了某种信号传递。
现在,在一个从没学过生物学的模型给出的坐标里,这个细胞的基因表达谱,最像一只青蛙的腺细胞——也就是说,它很可能是在管消化和分泌,跟神经没多大关系。
一个沿用了一个多世纪的名字,被一个纯粹靠"15 亿年表达数据"自己长出来的坐标系,轻轻否掉了。这大概是这类工作最迷人的地方:它不懂生物,所以它不背教科书的包袱。
还有一条更隐蔽的线索。UCE 那个"RNA 袋"的设计灵感,来自 Sydney Brenner——2002 年诺贝尔生理学或医学奖得主,线虫研究的奠基人。他当年说过,与其把细胞想象成一个精密电路,不如就把它想成一袋 RNA。二十多年后,这句带着点脾气的老话,变成了一套 24 块 A100 跑 40 天的工程方案。
如果把这个发现放回"文明原点·100人工程"的坐标里看,会多出一层意思。人类文明的技艺是靠文字、师承、器物往下传的——刻错一笔、断了一代,就可能彻底失传。而生命把 15 亿年攒下来的做法,全压在蛋白质序列和表达调控里,一个字都没写下来,却一次都没断代。TranscriptFormer 干的事,本质上是一场考古:只是它挖的不是地层,是坐标;它找的不是陶片,是六亿年前某一类细胞留在分子里的口音。那些用一辈子把一门手艺钉进文明的人,和用一次转录把一项功能钉进后代的细胞,做的是同一件事——不让有用的东西丢掉。
❖